iPhone版
 Android版
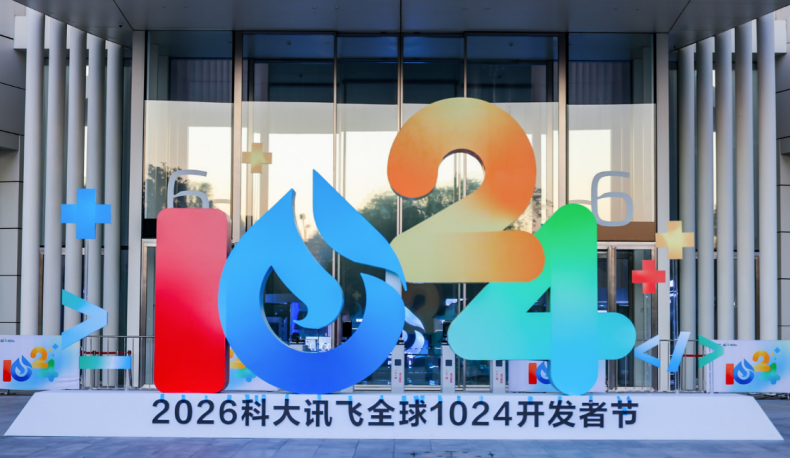
1024是什么?对于写代码的“码农”们,它是2的10次方,是1KB背后的那个基础单元,也是二进制的图腾。
但对于科大讯飞来说,它是一扇每年打开一次的潘多拉魔盒,也是科大讯飞背后生态圈开发者们的年度盛会。
前两年,作为AI时代观众的我们见多了擅长输出的AI,2026年的科大讯飞全球1024开发节,将主题设为了“解放生产力,释放想象力”。
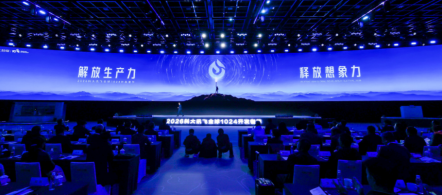
也就是说,科大讯飞已经把对AI的目光从能不能进行精确问答,转向了更加落地的真实业务场景和物理世界方向。
但在真实生活中,人们不会总像填写指令一样去向AI完整准确表达自己的需求,因此AI要融入其中,就不能只识别孤立的指令,更要能理解场景并跟上交流,再根据交流对行动进行调整,但这说着容易,做起来却必须跨过一道交互的门槛。
科大讯飞面对这一问题,已经给出了自己的解决方案,从语音交互到多模交互,最后到具身多模交互。
这一进阶路径体现出了科大讯飞从音频与语音理解,到融合视觉信息、记忆与上下文的多模态场景理解,再到动态环境下的感知、交互与动作执行的协同,推动AI从单纯响应指令,向场景化需求理解与任务协同执行拓展。
一
让AI在嘈杂世界里听清并听懂
让AI进入日常生活,语音是一个自然的入口,但入口并不等于能拥有一个好的体验,要让语音交互真正可用,仅仅把人声转成文字是远远不够的,还会遇到很多的问题。
比如强噪声干扰下能否准确识别?多人交替甚至是发言时能否区分说话的人是谁?面对人声、音乐与环境声混杂的音频,能否提取到有效信息并理解现场情境?这些真实世界里的复杂问题,考验的不是某一个单项的识别能力,而是语音技术的整体系统性积累。
而这正是科大讯飞长期深耕的优势领域,讯飞围绕语音识别、语音合成、声纹识别等方向持续积累,并在输入法、转写、翻译及智能终端等产品中不断打磨。
从底层研发到产品落地,科大讯飞长期面对复杂声学环境和多样化用户需求,让讯飞的语音优势不只体现在单项指标上,更体现在如何把技术转化为实际交互体验的能力上。
换句话说,讯飞在语音领域的强者地位,不是靠一次模型发布确立的,而是在长期高复杂度场景中反复验证出来的。
也正因如此,当行业开始讨论“音频理解”这个新概念的时候,科大讯飞并不是一个从零开始的layman,而是把已经跑通的识别、合成、分离与翻译能力,重新编排成一个能推理声音世界的模型,在长期积累下终于开出了自己的硕果。
如今,大模型正在把语音交互推向新阶段,AI不仅要识别语言内容,还要综合理解说话人、情绪与环境声音,让声音成为判断意图、获取场景信息的重要依据。
因此对语音领域的技术领先者而言,下一阶段的竞争力,在于能否把已有积累转化为更全面的声音理解能力。
此次科大讯飞发布的星火语音基座大模型SparkAudio 1.0,正是它沿着这一方向持续演进的成果,它承接了讯飞长期的语音技术积累,在支撑语音识别、同传和交互的基础上,进一步拓展音频理解、情绪识别、实时说话人分离和环境声理解能力,将技术边界从“听清语言”推进到了“理解声音”上。
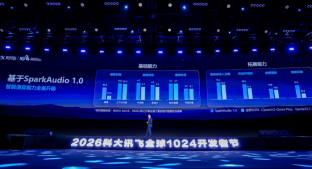
一句话是谁说的?说话时带着什么情绪?背景里的声音意味着什么?当多人同时交谈时,哪些话属于同一个人?这些往往无法由转写文本完整承载的信息,正在成为AI理解用户与现场情境的新线索。
在1024开发者节主论坛现场的一段演示展示了这种变化,仅凭一段电影音频,SparkAudio 1.0便能分析其中的人物对话、背景音乐和车辆等声音,并据此推断场景,有着刑侦剧中“声音侦探”的类似能力。
即使是置身嘈杂的街头,SparkAudio 1.0也能辨别喇叭声、叫卖声、车轮摩擦地面的声音,分清交织的人声,从声音线索中推理周围环境,不仅能“听清说了什么”,更能“听懂发生了什么”。
这意味着,用户不必先把周围的环境单独整理成一份清晰完整的文字说明,AI能自己从声音中获取更多上下文,语音也不再只是输入指令的通道,而是开始成为AI感知真实世界的重要方式。
而支撑这一升级的,是半监督音频编码器、动态分段端到端建模、双范式协同解码三项技术创新。
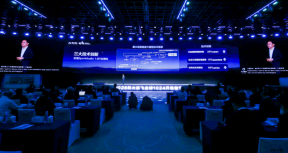
据科大讯飞公布的相关测试结果,SparkAudio 1.0的整体效果提升了20%,响应时间降低了15%、成本更是降低了60%。
这三个维度共同指向着语音技术能走向规模化应用的关键,即理解更准确,才能减少反复确认;响应更及时,交流才更自然流畅;成本更低,相关能力才更容易进入更多终端和高频场景。
想引领下一代语音交互,不仅要拓展模型能力边界,也要让这些能力成为用户日常可用的体验,效果、时延、成本三条曲线同时优化,意味着科大讯飞的模型能力升级没有以变得更笨重为代价。
而从模型到产品,讯飞走的是一条边上线边迭代的路,输入法里的方言和口语表达、听见里的会议与访谈、办公本里的纪要场景,每天都能给SparkAudio 1.0反馈真实的失败样本,这种迭代闭环才是语音优势里最难被复制的。
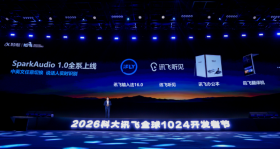
目前,SparkAudio 1.0已在讯飞输入法16.0、讯飞听见、讯飞智能办公本等产品中上线,从长期技术积累,到基座模型升级,再到多类产品承接,讯飞正在把语音领域的深厚优势转化为新一代交互能力,也为行业从“语音识别”走向“综合声音理解”提供了一条可实践的路径。
二
AI开始“看懂”并理解场景
从理解声音再向前一步,AI需要面对的是更完整的场景。
比如用户说“这个”“那边”这种模糊不清的词语时,指向的对象可能就在眼前;当多人进行交流时,可能一句话的含义往往需要结合说话人、讨论对象和前后文才能判断;在面对一个新的需求,用户此前表达过的偏好,也可能成为理解意图的重要依据。
这意味着,AI不仅要能听会说,还要将听到的声音、看到的画面与获得授权后保留的记忆联系起来,判断谁在说话、说的是哪个对象,以及这些信息与当前需求有什么关系。
多模态交互的价值,不是简单给语音助手加上一颗摄像头就完事了,而是要让不同来源的信息进行准确对应和相互补充,共同参与理解与推理。
这也是AI从“语音助手”迈向“场景 Agent”的关键一步:结合情境理解需求,再通过任务规划与工具调用,在用户授权下协同完成任务。
科大讯飞此次发布的多模交互技术,进一步融合了多模远场识别、多人交互、视听觉融合理解、个性化记忆和情感语义,推动交互能力从识别单一指令,走向理解更丰富的场景信息。
其中,远场识别帮助系统适应人与设备之间的距离变化,多人交互帮助区分不同参与者,视听觉融合理解将声音与眼前的人物、物品和环境联系起来,个性化记忆与情感语义,则补充历史偏好、表达情绪等线索。
这些技术能力都共同指向一个目标:让AI不只处理眼前的一句话,也能结合上下文判断用户真正需要什么,这种升级,在星火智慧座舱与讯飞 AI 眼镜上,呈现出两条具体的应用路径。
汽车是检验交互能力的典型场景,因为车内有不断变化的环境噪声,也有不同座位乘员参与的交流,用户的需求也常常会跨越导航、餐饮、接待等多个环节。
因此要提供自然的交互体验,车机既需要理解表达,也需要辨别需求来自谁,并结合当前情境衔接后续服务。
如果系统只能响应单条指令,用户就必须自己拆解需求,将一件完整的事情转换成一连串操作,星火智慧座舱3.0展示的方向,则是让系统承接更完整的出行意图。
10月21日在讯飞智能汽车技术发布会上亮相的星火智慧座舱,被官方称为是业内首个全模态类人交互座舱,它以Sophia架构为底座,把舱、驾、声放进同一份情境里共享,舱驾融合控制器(AIBOX)来统一承载全车Master Agent,把智舱、智驾、音响三套系统的隔阂给打通。
在主论坛现场播放了一段视频:主持人华少快速、连续地提出了一长段初到一座城市的办事和接待需求,系统随后完成路线规划、店铺推荐和餐厅预订,展示了从复杂表达中提取任务、理解任务关联,并衔接具体服务的能力。
这段演示的重点,不只是AI能否跟上语速,而是它能否保留一段表达中的多重要求,将分散的信息组织成可执行的任务。
它背后的支撑是一套从感知到记忆再到执行的组合:54个维度、2808个记忆锚点,加上多模态感知与S2S语音到语音,你夏天怕晒、冬天上车想暖脚、副驾咖啡不加糖,说过一次它就能记住,并且全车四个音区的分布,不管谁在说话都分得清。
据科大讯飞公布的数据,星火智慧座舱3.0能提供超100项多模感知能力,多模感知成功率超95%,模糊理解准确率超93%;复杂出行意图的理解准确率约95%。
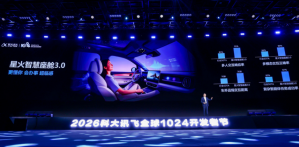
在实际应用中,你只说“上午开会、中午见客户、下午把电充上”,Master Agent就自己拆解优先级,把空调、餐厅、路线这些全都帮你安排好。
这套组合的妙处在于“同一份情境,全车共用”,过去空调、导航、音响、智驾各听各的,用户得先想清楚该对哪个模块说话,现在Sophia架构让舱内谁在说、说什么、车处在什么状态都能清晰地落在同一张情境图上。
也就是说所有系统里只有Master Agent才有资格做全局排序,是先送你到会场,还是先绕去取咖啡,它自己会进行权衡。
此外,支付宝车载助手也接进了Master Agent,“讯宝计划”把高速无感通行、停车无感支付、顺路取快递、智能点单跑成了闭环;站在车外几十米,照样能跟它沟通。
这些能力给用户带来了不一样的体验变化,不再要求用户去适应车机的指令格式,而是让车机适应人的自然表达,当感知、记忆、理解与工具调用相结合时,智慧座舱便有机会从“听令操作的车载助手”,进一步成为理解出行情境、协助安排事务的服务入口。
如果说智慧座舱是在相对固定的出行空间中理解人,AI眼镜则将交互入口带到了用户随身移动的视角,用户看到什么、听到什么,往往就是当下任务的背景。
因此眼镜的价值,不只是多一种拍摄或录音方式,而是怎么让声音与画面一起进入AI的理解过程,减少用户在现场经历与事后描述之间反复转换的负担。
硬件先解决“听得清”的问题,讯飞AI眼镜整机重约40克,通过5麦阵列、骨传导与唇动识别协同改善复杂环境拾音,90dB展会级噪声下仍能抑制,8米外也能收得到,唇动识别体现的正是视听融合的意义,视觉信息不仅用于识别画面,也能参与声音处理,帮设备把目标人声捞出来。
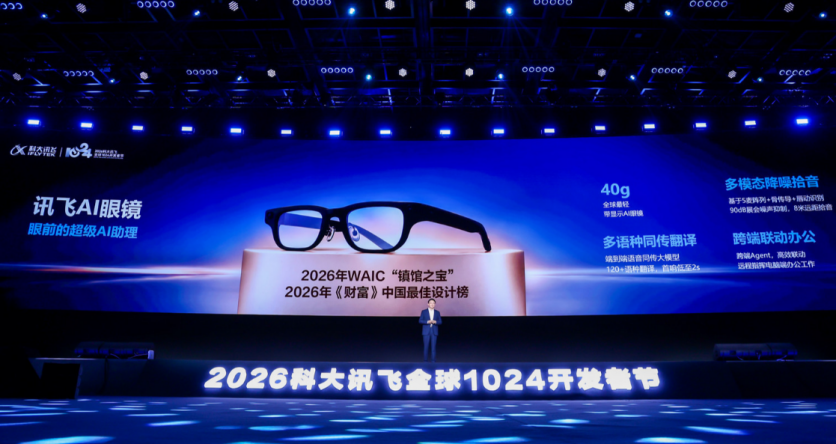
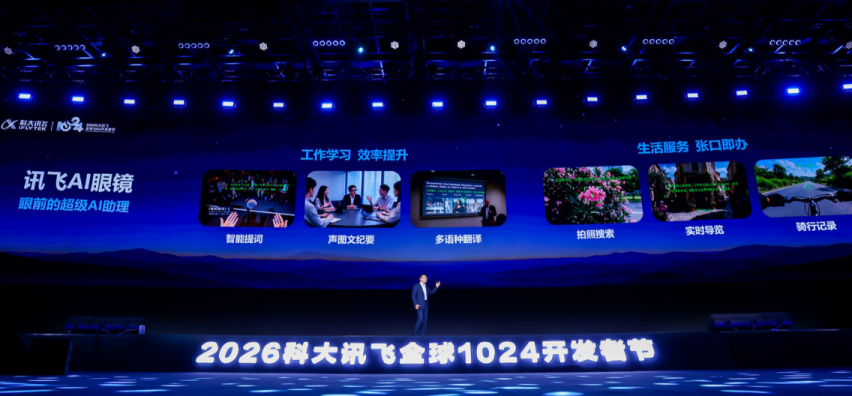
产品还支持120余种语言翻译,同传首响低至2秒,并具备智能提词、声图文纪要、拍照搜索、实时导览等功能。
重量在这里不是简单的参数,而是交互是否成立的前提,如果是一副戴一整天就累的眼镜,就算给它加上再聪明的Agent也会被用户摘下来,而一旦离脸,它就看不见你的视线,也听不清你的声音了。
因此讯飞AI眼镜的40克重量、贴近面部的多麦与骨传导等设计,正是为了把入口给“焊”在身上。
主论坛上的演示,让这一过程更加直观。
科大讯飞穿戴业务事业部总经理林会杰展示了通过眼镜记录的刘庆峰演讲纪要,其中既有内容梳理,也有现场图像,随后,他与西班牙语、英语使用者分别用各自母语交流,由眼镜实时翻译,他还通过眼镜点咖啡,并联动电脑端处理办公任务。
这些演示呈现的不只是功能数量的增加,而是从现场信息获取、沟通理解,到后续任务处理的连接,声图文纪要让记录保留更多现场上下文,跨端联动则进一步将随身设备获取的信息接入办公流程,眼镜由此不再只是采集信息的设备,也开始成为连接现场情境与后续行动的入口。
从座舱到眼镜,这两类产品的共同变化,是AI不再只围绕一句话给出回答,而是尝试围绕一个场景提供服务,听见的、看见的和记住的信息相互补充,让AI可以获得更充分的判断依据,任务规划与工具调用则让这种理解有机会转化为实际行动。
而这也延续了讯飞从语音能力向新一代交互能力拓展的技术路径:从听清声音,到融合多模态信息理解场景,再到协同完成任务。
多模态交互的升级,最终不是让用户面对更多功能,而是让用户少解释背景、少拆分步骤,更自然地表达需求。
三
让机器人“边交流边行动”,从表演舞台走进日常生活
当AI的载体从座舱、眼镜延伸到机器人时,交互所面临的挑战就又增加了一层。
因为机器人不仅需要理解人的需求,还要在空间中移动、操作物体,并根据新的指令来调整行动,人与机器的距离在变,声源方向在变,任务进度也在变,这意味着,机器人不能先完成一轮对话,再机械地执行一套固定动作,交流与行动必须持续衔接。
“大家千呼万唤,期待机器人从运动会、表演舞台走向日常生活、走进千家万户。”刘庆峰在主论坛上表示。
从舞台展示到日常服务,运动能力固然重要,但机器人同样需要知道何时回应、回应谁,以及如何在任务执行中理解人的新要求,而具身多模交互,正是对这一环节的补强。
针对这些挑战,科大讯飞发布了星火具身多模交互技术,在复杂空间动态降噪、多目标人的交互意图识别、语音与动作统一规划与执行、视觉触发的主动交互等方面取得突破,让机器人在动态环境中既能与人交流,又能协同完成任务,为其进入家庭和社会服务场景提供关键技术支撑。
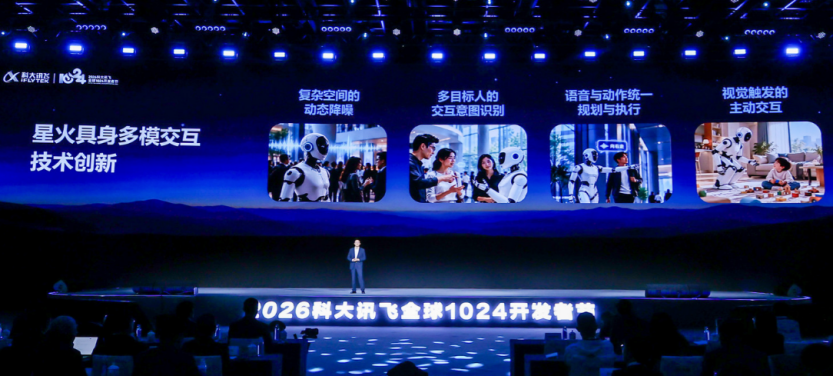
如果说座舱和眼镜面对的仍是“人站着不动、设备跟着人走”的相对关系,机器人则要更加复杂,它需要一边走一边听,声源角度是随转身变化的,而机械臂一动,电机噪声可能就会盖住耳边的人声,还可能会面临当机器人任务执行到一半时人突然改变需求的情况。
而讯飞给出的四个突破,正好能对上这些难题,动态降噪解决“听得见”,多目标意图识别解决“听谁的”,语音与动作统一规划解决“边说边做”,视觉触发主动交互则解决“人还没开口,它已经该搭话了”。
主会现场也展示了机器人超市、机器人物流驿站,在现场嘈杂、多人围观的情况下,机器人都准确完成了任务。
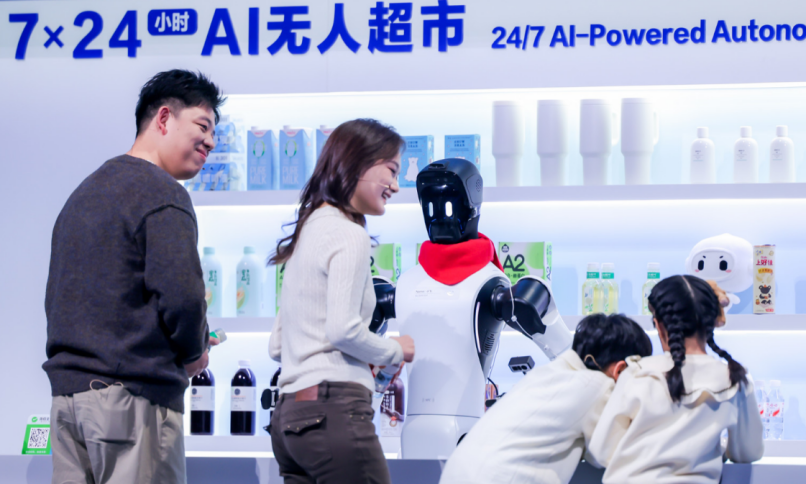
像这类任务的难点,不是说孤立地完成一次取货这么简单,而是在多人参与、需求变化的情况下,保持对交流对象、任务内容和执行进度的持续理解,它展示的,是机器人从“按指令做动作”走向“在交流中完成任务”的可能性。
技术上的“不讲道理”更能说明问题,平台的多模态方案在-10dB噪声环境下的识别准确率仍可达90.1%,电机啸叫、激光雷达嗡鸣、人群嘈杂都压不住它,谁在说话、在哪说、说了什么照样分得清。
比如一家人围着机器人同时开口要水、要零食、换口味,它能把需求和具体哪个人对上号。
除了把语音与动作统一规划、一并执行,机器人还能主动起来,当看见人走近会问一句有什么需要,看到小孩趴在桌上会提醒坐姿。
当然,越靠近人的身体,边界也越清楚,唤醒与拾音该有多远的有效半径、误唤醒怎么快速撤回到安静状态、动作执行前哪些动作需要二次确认,都得是可配置、可审计的。
为承接这些能力,科大讯飞还同步推出了机器人超脑平台V3.0,整合星火超脑板、具身智能开发套件、多模态交互模组及具身多模交互Harness,通过端云协同、前后台协同,让机器人前台畅聊不停、后台持续办事,并支持模块化、配置化的行业定制。
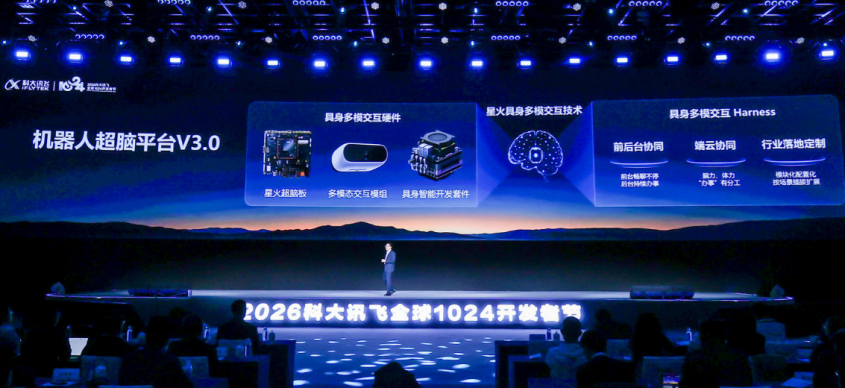
目前平台已接入500余家机器人企业、10万余台设备,覆盖政企服务、辅助医疗、养老康养、家庭服务、教育陪伴等场景,这一步,才是机器人从“舞台表演”走向“日常服务”的前提。
四
结语
从语音交互到多模交互,再到具身多模交互,是AI面对更复杂场景时的能力递进,从听清并理解表达,结合情境判断需求,进而在真实环境中协助完成任务。
这条进阶路径也说明,AI走进日常生活,不能只靠模型能力的单点突破。
眼镜能否在嘈杂环境中有效拾音,需要传感器与算法协同;座舱能否承接完整的
出行需求,需要感知、理解与服务调用衔接;机器人能否边交流边办事,则需要
感知、规划与执行系统共同配合。
软硬一体的价值,正是让模型的能力边界,转化为用户实际可用的体验。
对科大讯飞而言,座舱、眼镜与机器人所呈现的,不只是产品形态的拓展,更是长期语音技术积累向场景理解、任务执行的持续延伸,从语音领域的深耕出发,将多模态感知、理解推理与行动能力逐步连接,讯飞正在把既有技术优势转化为面向下一代人机交互的系统能力。
而引领交互方式的演进,不仅在于推出新的模型和终端,也在于让相关能力被更广泛地使用。
以产品验证技术,再通过模组、开发套件与平台向开发者开放,才能让交互创新从少数示范场景走向更多行业和日常生活,这也是此次开发者节所展示的另一层价值,既探索 AI 如何进入真实世界,也为更多开发者参与这一过程提供支撑。
物理世界的交互,最终是个长期攻坚的挑战,所以这一次1024真正值得记住的,未必是又多了一个“最强大模型”的名头,而是AI在一连串不那么标准的提问里,顺着你的声音、你的视线、你临时改的主意,顺顺利利地帮你把事情办了。
从听清一句话,到理解一个场景,再到协助完成一件事,AI走出对话框,不是换一种设备继续回答问题,而是逐步适应人的表达习惯、所处情境与办事方式。
这也将成为新一代人机交互能否走进千家万户的关键。
新识研究所
咸宁日报旗下,关注互联网、科技与新产业